TabFM es un modelo desarrollado por Google Research para tareas de clasificación y regresión. Introduce un enfoque diferente al de los workflows tradicionales de machine learning aplicados a datos estructurados.
No requiere entrenar un nuevo modelo con los propios datos. En su lugar, utiliza in-context learning: los datos históricos se proporcionan como contexto y TabFM utiliza esos ejemplos para generar predicciones directamente durante la inferencia.
Conceptualmente, este enfoque es similar al de los modelos de lenguaje cuando reciben ejemplos directamente dentro de un prompt.
Google también ha integrado TabFM directamente en BigQuery, donde puede utilizarse mediante SQL con AI.PREDICT y evaluarse con AI.EVALUATE, sin necesidad de gestionar por separado el entrenamiento y el despliegue del modelo.
Esto nos llevó de forma natural a plantearnos una pregunta:
¿hasta qué punto puede ser competitivo este enfoque frente a los modelos de tipo ML que ya utilizamos dentro de la ByTek Prediction Platform?
Así que decidimos realizar algunas pruebas.
Metodología del análisis
Seleccionamos tres datasets reales con características bastante diferentes y comparamos TabFM con los modelos BPP en tareas de clasificación.
Una precisión importante: no se trata de un benchmark definitivo ni pretende establecer qué tecnología es mejor en términos absolutos.
Es un análisis exploratorio basado en tres casos concretos que nos parecieron suficientemente interesantes como para compartirlos.
Los datasets:
Dataset A
Principalmente features demográficas y relacionadas con el canal.
Tasa de positivos: 6,5 %
Dataset B
Features de comportamiento más ricas, como trials, demos y accesos.
Tasa de positivos: 11,8 %
Dataset C
Datos demográficos y transaccionales.
Tasa de positivos: 27,9 %
Para comparar el rendimiento, nos centramos principalmente en dos métricas: ROC-AUC y PR-AUC.
La ROC-AUC mide la capacidad del modelo para ordenar correctamente el conjunto de la población, separando los casos con mayor probabilidad de ser positivos de aquellos con mayor probabilidad de ser negativos.
La PR-AUC, en cambio, se centra más en la capacidad del modelo para identificar correctamente los casos positivos. Resulta especialmente relevante cuando la clase positiva es minoritaria y cuando, desde un punto de vista operativo, importa sobre todo la calidad de las primeras posiciones del ranking.
Resultados de la comparación
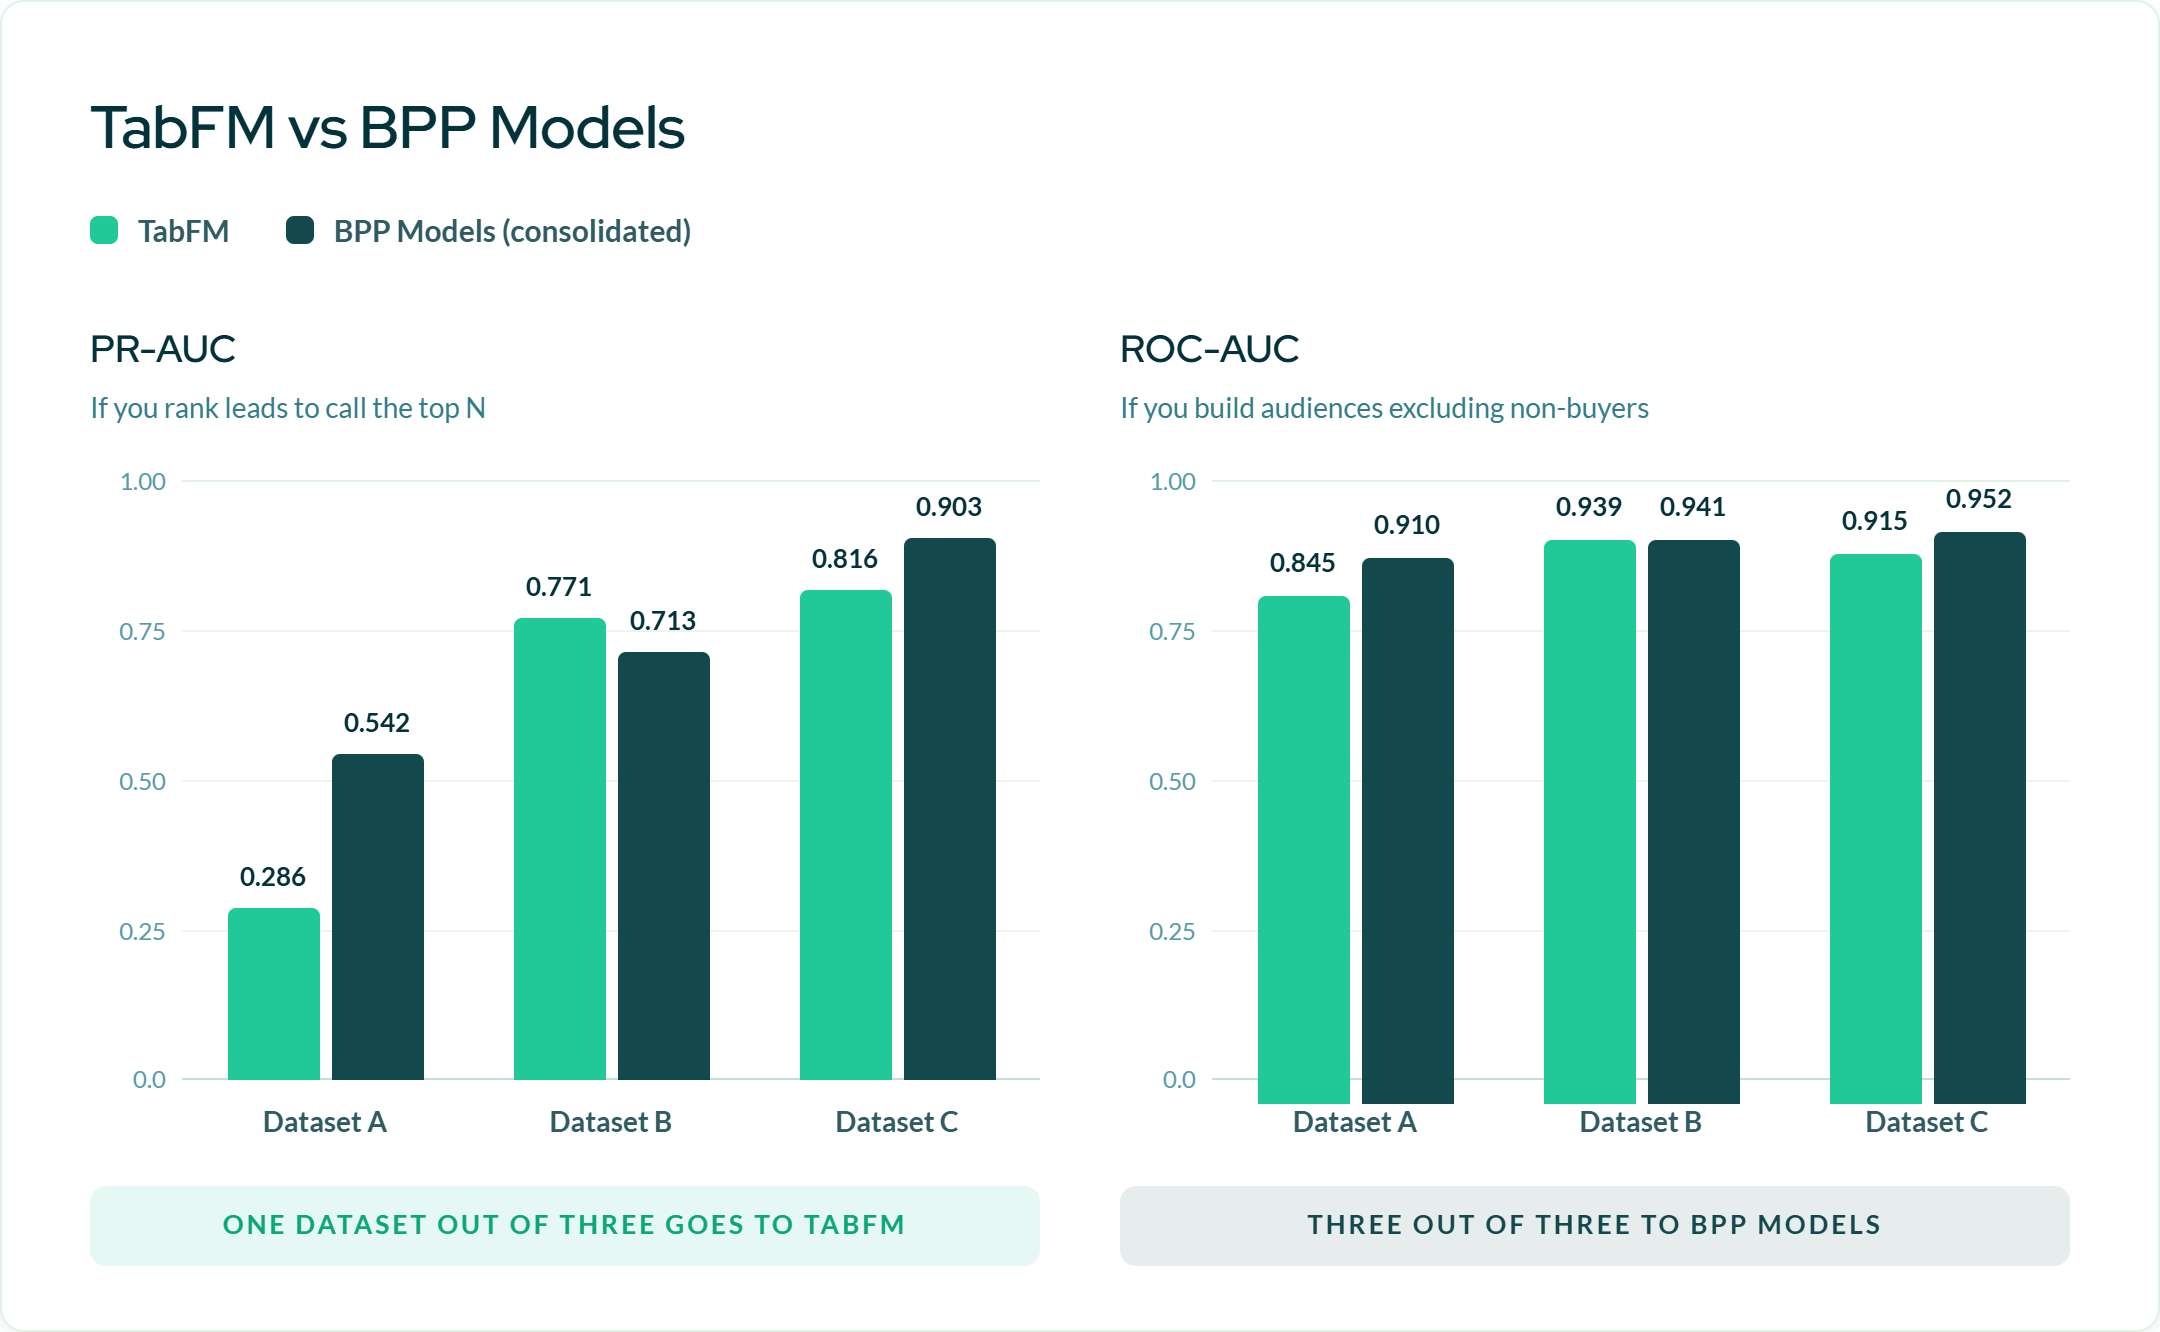
En ROC-AUC, los modelos BPP obtuvieron los mejores resultados en los tres datasets.
En el Dataset B, sin embargo, la diferencia fue de solo 0,002 puntos, por lo que en la práctica el resultado fue muy similar.
El escenario es más matizado en PR-AUC.
Los modelos BPP obtuvieron mejores resultados en dos datasets: con una ventaja clara en el Dataset A y con una diferencia más reducida en el Dataset C.
TabFM obtuvo, en cambio, mejores resultados en el Dataset B, el que contiene las señales de comportamiento más ricas.
Los resultados, TabFM vs modelos BPP:
| Dataset | PR-AUC TabFM | PR-AUC BPP | ROC-AUC TabFM | ROC-AUC BPP |
| A | 0,286 | 0,542 | 0,845 | 0,910 |
| B | 0,771 | 0,713 | 0,939 | 0,941 |
| C | 0,816 | 0,903 | 0,915 | 0,952 |
Naturalmente, la métrica más relevante depende de cómo se vaya a utilizar la predicción.
Si el modelo se utiliza, por ejemplo, para ordenar leads y decidir cuáles contactar primero, la calidad de las primeras posiciones del ranking se vuelve fundamental, por lo que la PR-AUC puede ser especialmente significativa.
Si, en cambio, el prediction score se utiliza para crear audiencias, segmentar una población o excluir usuarios con una probabilidad muy baja de conversión, la calidad del ranking global se vuelve igualmente importante, por lo que la ROC-AUC resulta especialmente útil.
Impacto del aumento de los recursos computacionales
En el Dataset A quisimos comprobar si un aumento considerable del tamaño del contexto y de la carga computacional podía ayudar a reducir la diferencia.
Pasamos:
- de 1.000 a 10.000 filas de contexto;
- de 4 a 16 estimadores.
En términos de carga de trabajo, esto supuso un incremento de aproximadamente 40 veces.
La PR-AUC pasó de 0,249 a 0,286.
El primer aumento generó una mejora relativa de aproximadamente el 11 %. Después, cada nueva triplicación de los recursos produjo una mejora de alrededor del 1,8 %.
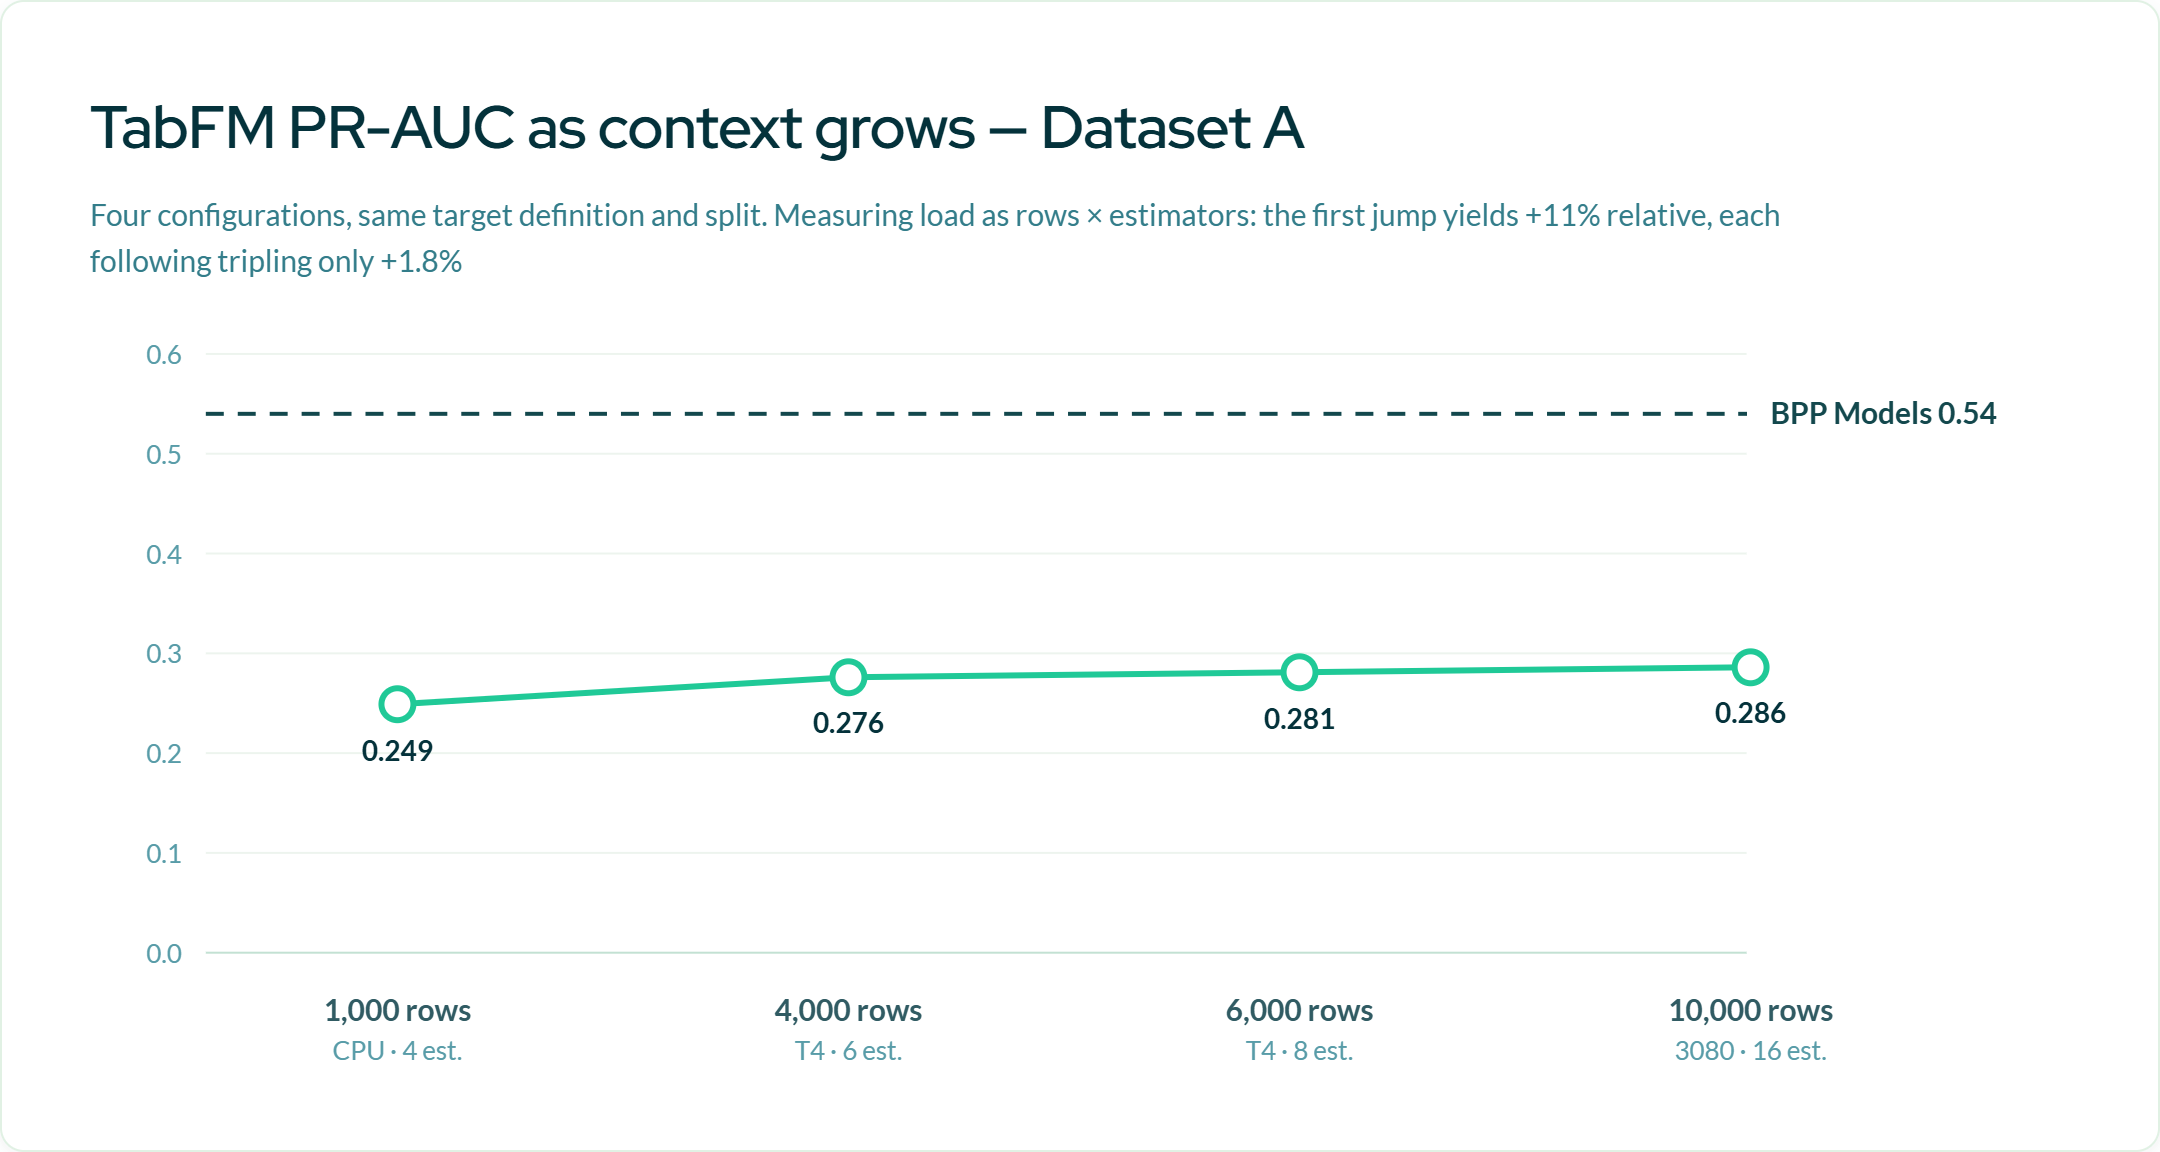
En este caso, por tanto, aumentar los recursos computacionales no fue suficiente para cerrar la diferencia con el modelo BPP.
Y aquí entra en juego otro aspecto importante de la evaluación: el rendimiento predictivo es solo una parte de la ecuación.
Limitaciones arquitectónicas y operativas
Durante nuestras pruebas con la librería de TabFM y sus pesos preentrenados, surgieron varias limitaciones que conviene tener en cuenta.
- Memoria disponible
En nuestras pruebas locales encontramos errores de out-of-memory antes de alcanzar algunos de los parámetros teóricamente disponibles en la librería, tanto con una Tesla T4 de 15 GB de memoria como con una RTX 3080 de 20 GB, utilizando un dataset de entrenamiento de unas 45.000 filas.
Esto está relacionado con la propia naturaleza del in-context learning: cuanto más histórico se proporciona como contexto, mayores son los recursos necesarios durante la inferencia.
La integración gestionada en BigQuery aborda este problema de otra forma, mediante sampling e inferencia distribuida, pero el principio sigue siendo el mismo: la cantidad de contexto afecta al coste computacional.
- Costes de inferencia
Con un modelo entrenado de forma tradicional, el mayor coste suele concentrarse en las fases de entrenamiento y reentrenamiento. Una vez creado el modelo, cada nueva predicción no requiere volver a interpretar todo el dataset de entrenamiento.
Con un modelo basado en in-context learning, en cambio, el contexto forma parte del propio proceso de inferencia.
Esto cambia también la forma en que deben evaluarse los costes, especialmente cuando el scoring debe repetirse con frecuencia o aplicarse a grandes poblaciones de usuarios.
En la integración con BigQuery, de hecho, el uso de TabFM está asociado a un modelo de pricing relacionado con la cantidad de tokens procesados.
- Restricciones del modelo
En la integración actual con BigQuery, los problemas de clasificación admiten hasta 10 clases y hasta 20 features.
La librería tampoco ofrece de forma nativa herramientas de feature importance comparables a las que utilizamos habitualmente en nuestros workflows, por lo que cualquier análisis adicional de interpretabilidad requiere procesamiento específico.
- Madurez y condiciones de uso
TabFM sigue siendo un proyecto relativamente reciente.
El código es open source, mientras que los pesos preentrenados actuales están sujetos a una licencia separada que limita su uso comercial y en producción. El repositorio también especifica que la librería no es un producto de Google oficialmente soportado.
La integración con BigQuery está disponible actualmente en Preview.
Son aspectos que tienen un impacto relativamente limitado durante una fase de experimentación, pero que se vuelven mucho más relevantes cuando se evalúa su adopción dentro de pipelines predictivos en producción.
Conclusiones
A partir de estas pruebas, hoy no vemos motivos para sustituir los modelos BPP.
En nuestros experimentos, obtuvieron los mejores resultados en PR-AUC en dos de los tres datasets y los mejores resultados en ROC-AUC en los tres.
Al mismo tiempo, el resultado del Dataset B nos parece especialmente interesante: con señales de comportamiento ricas, TabFM no solo se acercó mucho a nuestros modelos en ROC-AUC, sino que también los superó en PR-AUC.
Existe además un segundo escenario en el que este tipo de enfoque podría resultar especialmente relevante: los datasets pequeños.
Los modelos BPP deben aprender la estructura del problema a partir de los datos disponibles. Cuando el número de ejemplos es limitado, inevitablemente resulta más difícil construir un modelo robusto.
Un foundation model, en cambio, parte de conocimientos adquiridos durante el pre-training y utiliza los nuevos datos como contexto.
Probablemente este sea uno de los aspectos más interesantes que merece seguir explorándose.
El objetivo no es necesariamente sustituir lo que ya funciona, sino entender en qué condiciones un foundation model para datos tabulares puede ofrecer una ventaja frente a modelos predictivos consolidados.
Por ahora, por tanto, no estamos trasladando nada a producción.
Pero seguiremos probando TabFM y siguiendo su evolución.
Porque la pregunta más útil probablemente no sea simplemente “¿foundation model o modelos predictivos?”
Se trata más bien de entender qué enfoque utilizar, con qué datos y para qué tipo de decisión.