TabFM est un modèle développé par Google Research pour des tâches de classification et de régression. Il introduit une approche différente de celle des workflows traditionnels de machine learning appliqués aux données structurées.
Il ne nécessite pas d’entraîner un nouveau modèle sur ses propres données. Il repose à la place sur l’in-context learning : les données historiques sont fournies comme contexte, et TabFM utilise ces exemples pour générer directement des prédictions au moment de l’inférence.
Conceptuellement, cette approche est similaire à celle des modèles de langage lorsqu’ils reçoivent des exemples directement dans un prompt.
Google a également intégré TabFM directement dans BigQuery, où il peut être utilisé en SQL avec AI.PREDICT et évalué avec AI.EVALUATE, sans avoir à gérer séparément l’entraînement et le déploiement du modèle.
Cela nous a naturellement amenés à nous poser une question :
dans quelle mesure cette approche peut-elle être compétitive face aux modèles de type ML déjà utilisés au sein de la ByTek Prediction Platform ?
Nous avons donc décidé de réaliser quelques tests.
Méthodologie de l’analyse
Nous avons sélectionné trois jeux de données réels présentant des caractéristiques assez différentes et comparé TabFM avec les modèles BPP sur des tâches de classification.
Une précision importante : il ne s’agit pas d’un benchmark définitif, et notre objectif n’est pas d’établir quelle technologie est globalement la meilleure.
Il s’agit d’une analyse exploratoire basée sur trois cas spécifiques, que nous avons jugés suffisamment intéressants pour être partagés.
Les jeux de données :
Dataset A
Principalement des caractéristiques démographiques et liées aux canaux.
Taux de positifs : 6,5 %
Dataset B
Des caractéristiques comportementales plus riches, notamment les essais, les démos et les connexions.
Taux de positifs : 11,8 %
Dataset C
Des données démographiques et transactionnelles.
Taux de positifs : 27,9 %
Pour comparer les performances, nous nous sommes principalement concentrés sur deux métriques : ROC-AUC et PR-AUC.
La ROC-AUC mesure la capacité du modèle à classer correctement l’ensemble de la population, en distinguant les cas ayant une probabilité plus élevée d’être positifs de ceux qui ont davantage de chances d’être négatifs.
La PR-AUC, en revanche, se concentre davantage sur la capacité du modèle à identifier correctement les cas positifs. Elle devient particulièrement pertinente lorsque la classe positive est minoritaire et lorsque, d’un point de vue opérationnel, la qualité des premières positions du classement est essentielle.
Résultats de la comparaison
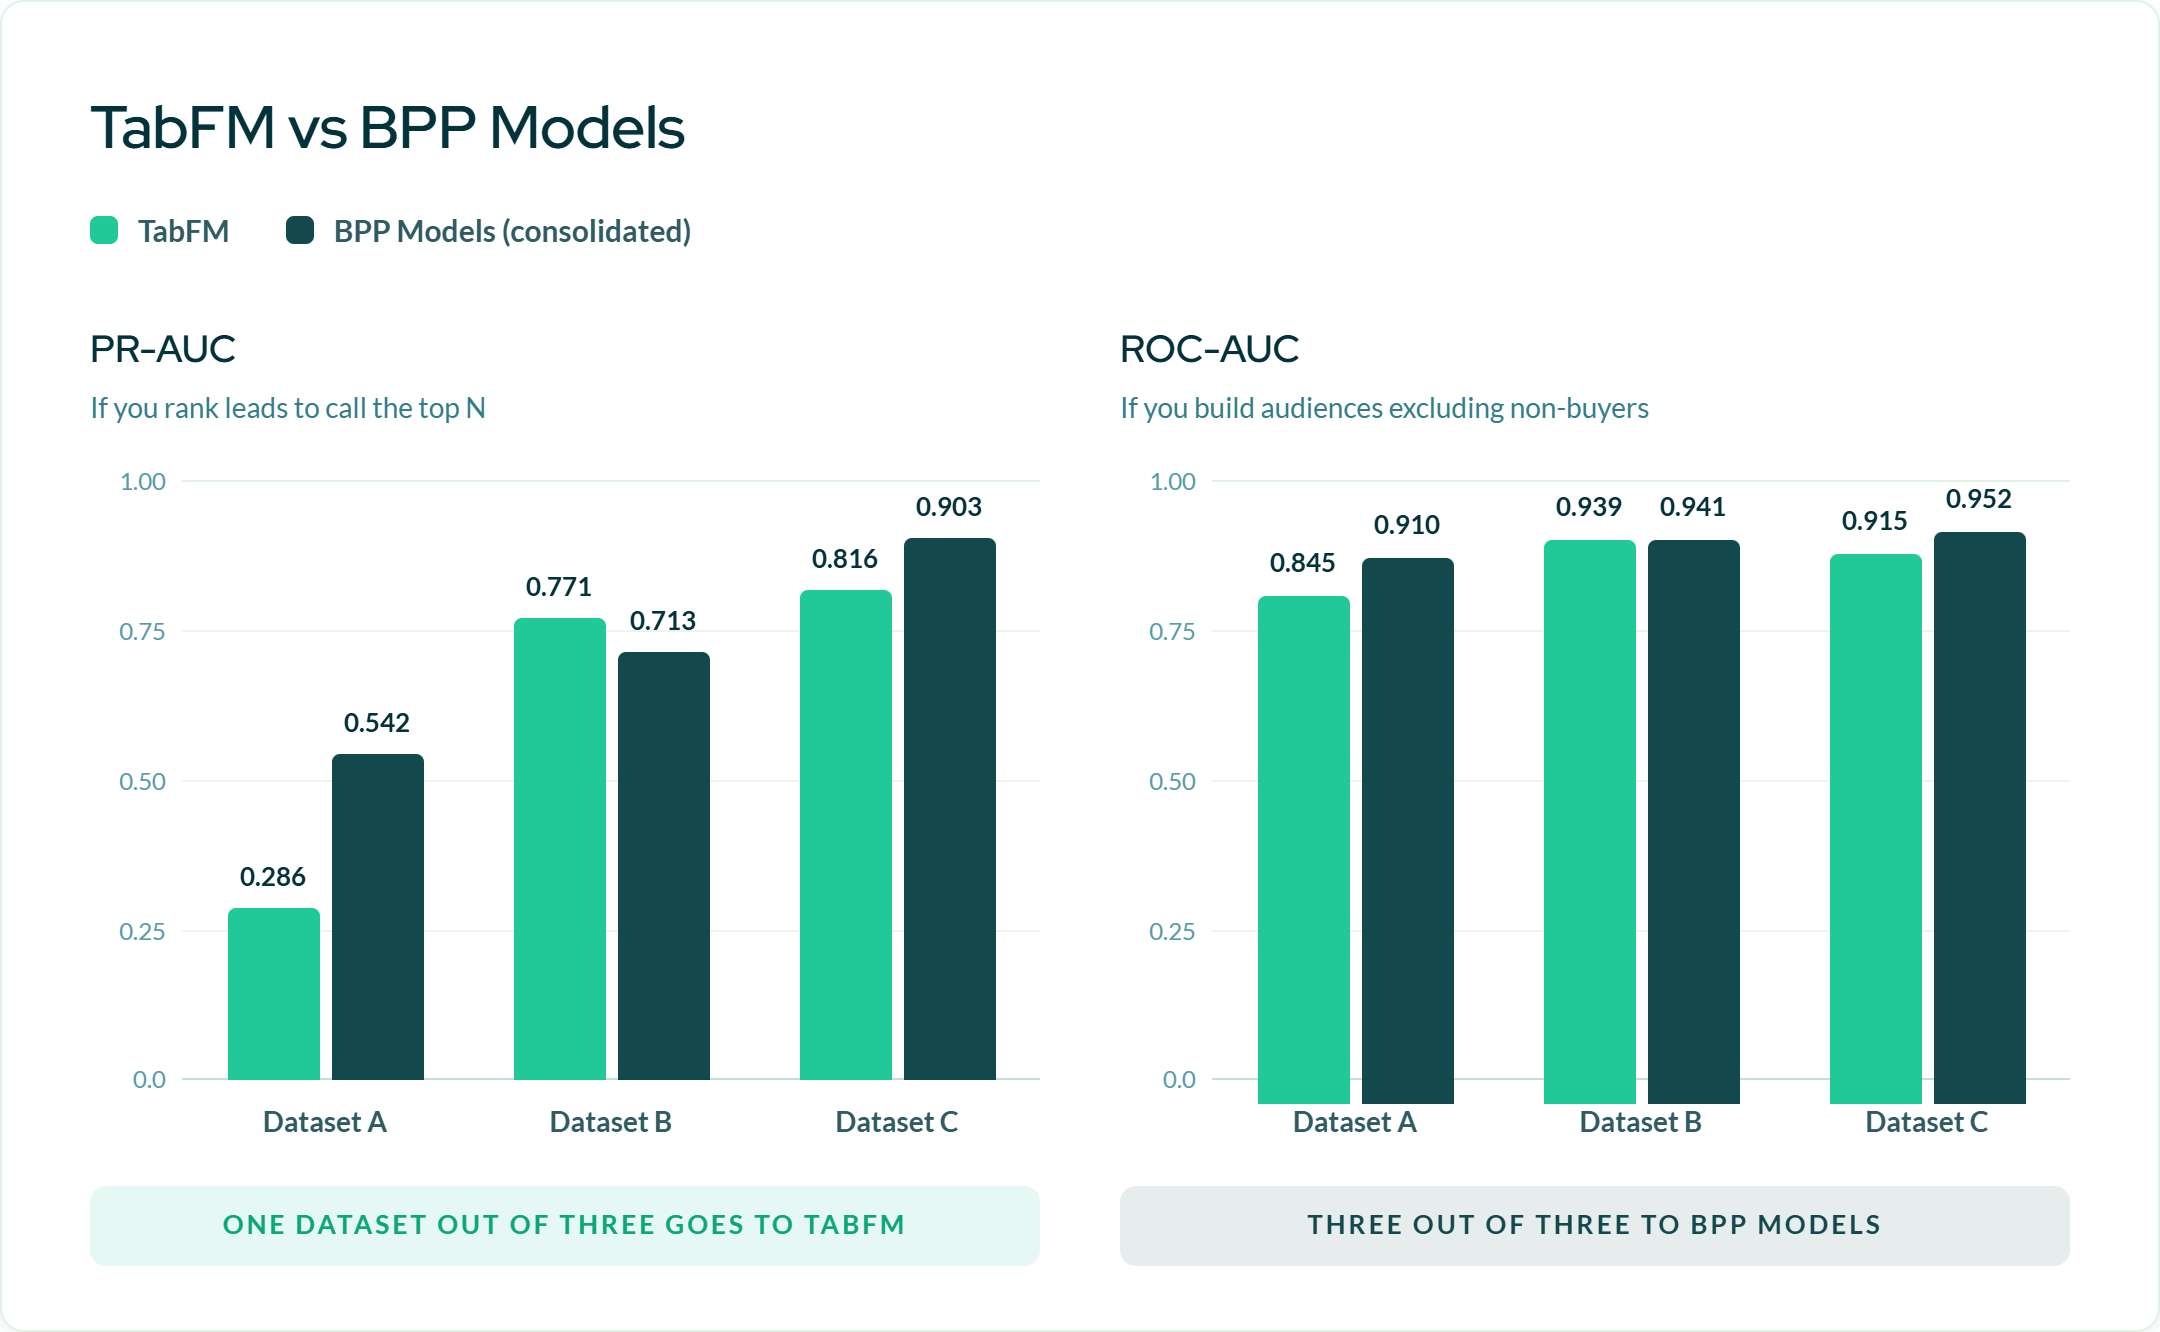
Sur la ROC-AUC, les modèles BPP ont obtenu les meilleurs résultats sur les trois jeux de données.
Sur le Dataset B, toutefois, l’écart n’est que de 0,002 point, ce qui correspond dans les faits à un résultat très proche.
La situation est plus nuancée pour la PR-AUC.
Les modèles BPP obtiennent les meilleurs résultats sur deux jeux de données : avec une nette avance sur le Dataset A et un avantage plus limité sur le Dataset C.
TabFM obtient en revanche de meilleurs résultats sur le Dataset B, celui qui contient les signaux comportementaux les plus riches.
Les résultats, TabFM vs modèles BPP :
| Dataset | PR-AUC TabFM | PR-AUC BPP | ROC-AUC TabFM | ROC-AUC BPP |
| A | 0,286 | 0,542 | 0,845 | 0,910 |
| B | 0,771 | 0,713 | 0,939 | 0,941 |
| C | 0,816 | 0,903 | 0,915 | 0,952 |
Naturellement, la métrique la plus pertinente dépend de la manière dont la prédiction va être utilisée.
Si le modèle sert, par exemple, à classer des leads afin de déterminer lesquels contacter en priorité, la qualité des premières positions du classement devient déterminante, ce qui rend la PR-AUC particulièrement pertinente.
Si, au contraire, le score prédictif est utilisé pour créer des audiences, segmenter une population ou exclure des utilisateurs présentant une très faible probabilité de conversion, la qualité du classement global devient tout aussi importante, ce qui rend la ROC-AUC particulièrement utile.
Impact de l’augmentation des ressources de calcul
Sur le Dataset A, nous avons voulu comprendre si une augmentation importante de la taille du contexte et de la charge de calcul pouvait contribuer à réduire l’écart.
Nous sommes passés:
- de 1 000 à 10 000 lignes de contexte;
- de 4 à 16 estimateurs.
En termes de charge de travail, cela correspond à une augmentation d’environ 40 fois.
La PR-AUC est passée de 0,249 à 0,286.
La première augmentation a généré une amélioration relative d’environ 11 %. Par la suite, chaque nouvelle multiplication par trois des ressources a apporté un gain d’environ 1,8 %.
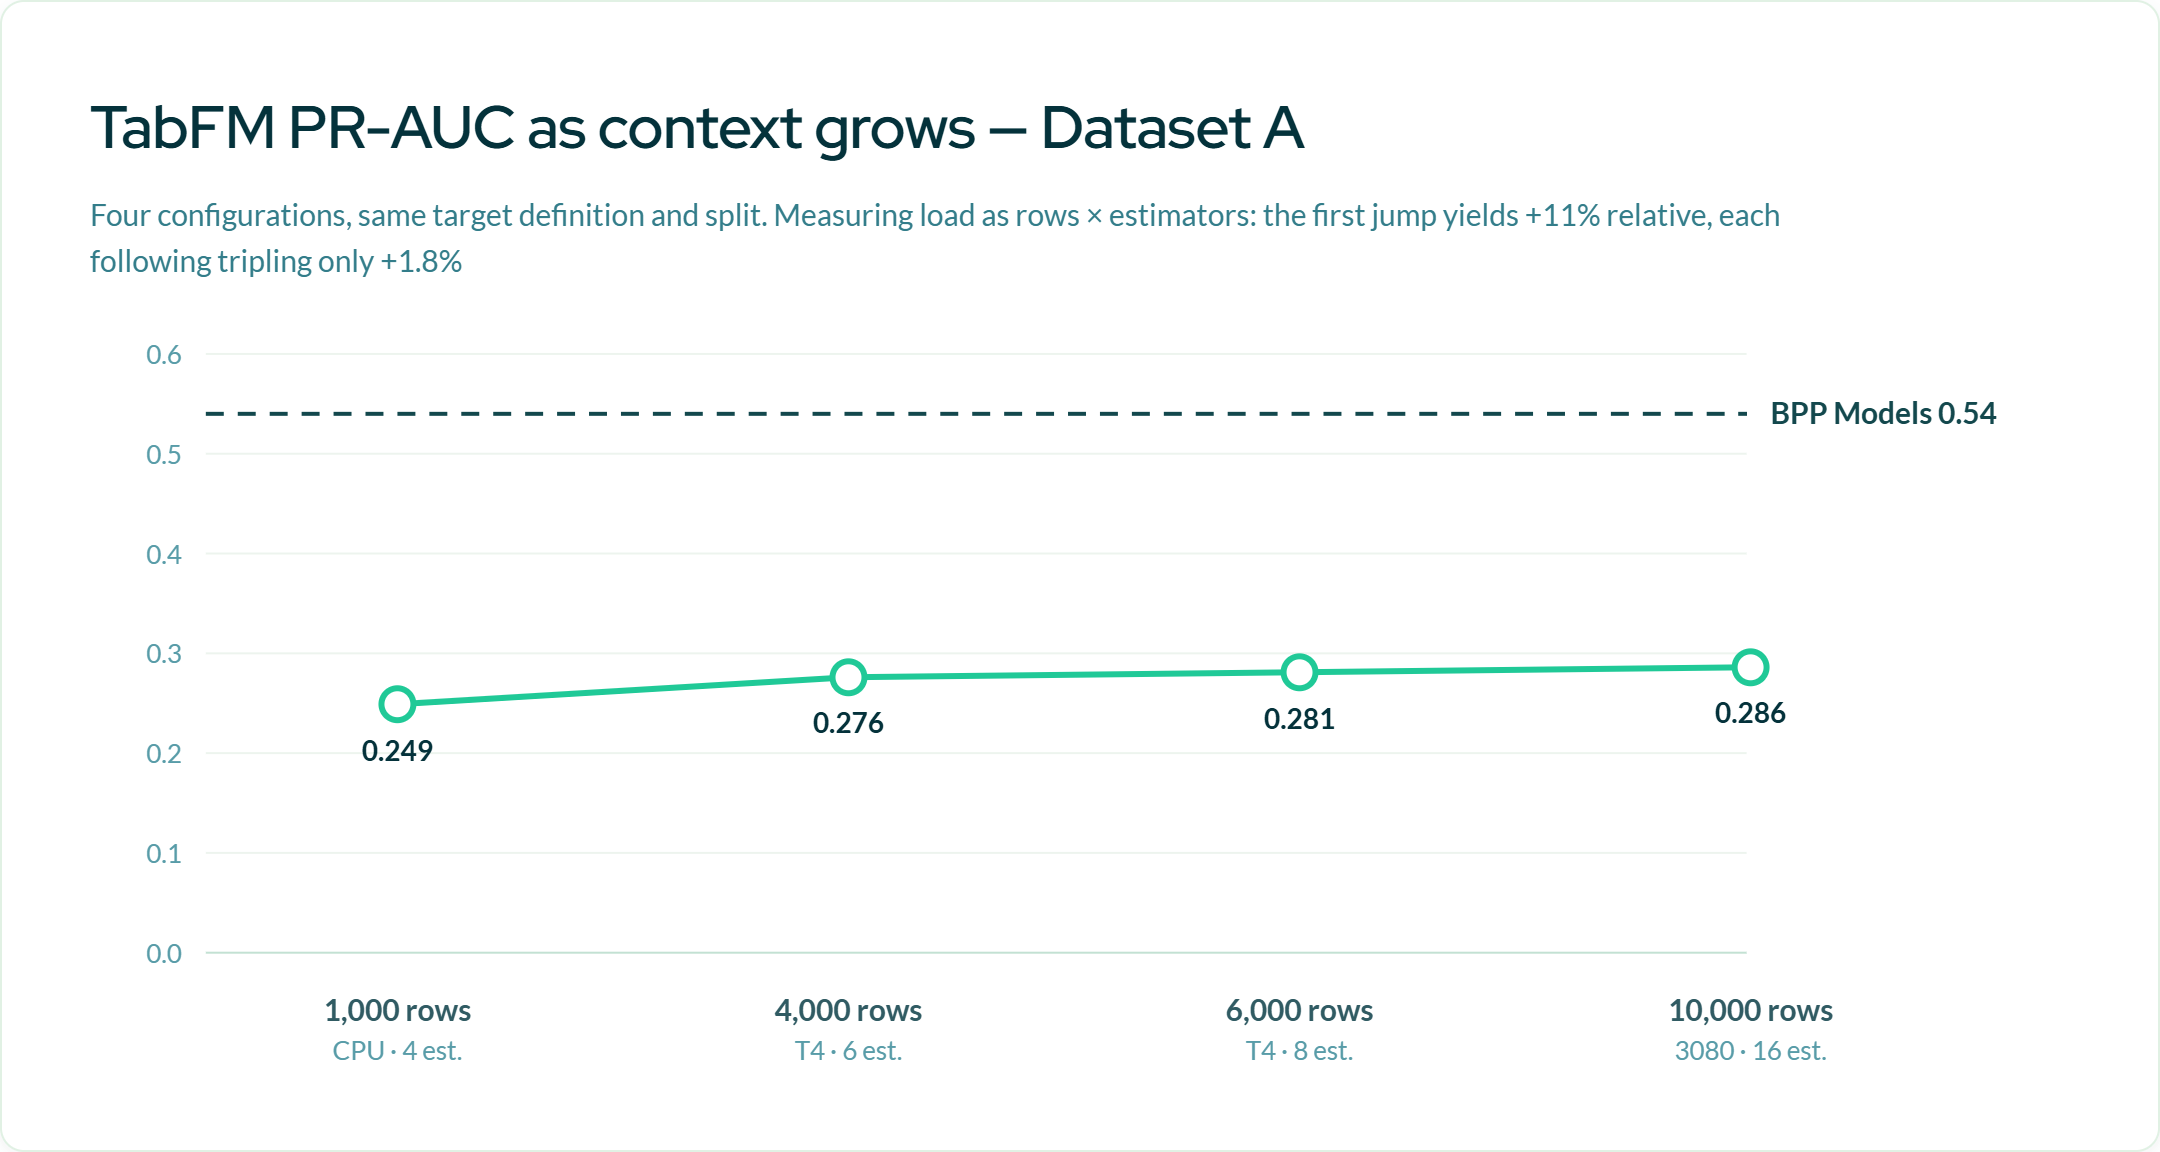
Dans ce cas, l’augmentation des ressources de calcul n’a donc pas suffi à combler l’écart avec le modèle BPP.
Et c’est ici qu’un autre aspect de l’évaluation devient important : la performance prédictive ne représente qu’une partie de l’équation.
Limites architecturales et opérationnelles
Lors de nos tests avec la bibliothèque TabFM et ses poids pré-entraînés, plusieurs limites sont apparues et méritent d’être prises en compte.
- Mémoire disponible
Lors de nos tests locaux, nous avons rencontré des erreurs out-of-memory avant même d’atteindre certains des paramètres théoriquement disponibles dans la bibliothèque, aussi bien sur une Tesla T4 avec 15 Go de mémoire que sur une RTX 3080 avec 20 Go, avec un jeu de données d’entraînement d’environ 45 000 lignes.
Cela est lié à la nature même de l’in-context learning : plus on fournit de données historiques comme contexte, plus les ressources nécessaires au moment de l’inférence augmentent.
L’intégration managée dans BigQuery gère ce problème différemment, notamment grâce à l’échantillonnage et à l’inférence distribuée, mais le principe reste le même : la quantité de contexte a un impact sur le coût de calcul.
- Coûts d’inférence
Avec un modèle entraîné de manière traditionnelle, le coût principal se concentre généralement sur les phases d’entraînement et de réentraînement. Une fois le modèle créé, chaque nouvelle prédiction ne nécessite pas de réinterpréter l’intégralité du jeu de données d’entraînement.
Avec un modèle basé sur l’in-context learning, en revanche, le contexte fait partie intégrante du processus d’inférence.
Cela modifie également la manière dont les coûts doivent être évalués, en particulier lorsque le scoring doit être répété fréquemment ou appliqué à de larges populations d’utilisateurs.
Dans l’intégration BigQuery, l’utilisation de TabFM est d’ailleurs associée à un modèle de tarification lié à la quantité de tokens traités.
- Contraintes du modèle
Dans l’intégration BigQuery actuelle, les problèmes de classification prennent en charge jusqu’à 10 classes et jusqu’à 20 features.
La bibliothèque ne fournit pas non plus nativement d’outils de feature importance comparables à ceux que nous utilisons généralement dans nos workflows. Toute analyse supplémentaire d’interprétabilité nécessite donc des traitements spécifiques.
- Maturité et conditions d’utilisation
TabFM reste un projet relativement récent.
Le code est open source, tandis que les poids pré-entraînés actuels sont soumis à une licence distincte qui limite leur utilisation commerciale et en production. Le repository précise également que la bibliothèque n’est pas un produit Google officiellement supporté.
L’intégration BigQuery est quant à elle actuellement disponible en Preview.
Ces aspects ont relativement peu d’importance lors d’une phase d’expérimentation, mais deviennent beaucoup plus significatifs lorsqu’il s’agit d’évaluer une adoption au sein de pipelines prédictifs en production.
Conclusions
Sur la base de ces tests, nous ne voyons aujourd’hui aucune raison de remplacer les modèles BPP.
Dans nos expérimentations, ils ont obtenu les meilleurs résultats en PR-AUC sur deux jeux de données sur trois, et les meilleurs résultats en ROC-AUC sur les trois.
Dans le même temps, le résultat obtenu sur le Dataset B nous paraît particulièrement intéressant : avec des signaux comportementaux riches, TabFM s’est non seulement rapproché fortement de nos modèles sur la ROC-AUC, mais les a également dépassés sur la PR-AUC.
Il existe également un deuxième scénario dans lequel ce type d’approche pourrait devenir particulièrement pertinent : les petits jeux de données.
Les modèles BPP doivent apprendre la structure du problème à partir des données disponibles. Lorsque le nombre d’exemples est limité, il devient inévitablement plus difficile de construire un modèle robuste.
Un foundation model, en revanche, part de connaissances acquises lors du pré-entraînement et utilise les nouvelles données comme contexte..
C’est probablement l’un des aspects les plus intéressants à approfondir.
L’enjeu n’est pas nécessairement de remplacer ce qui fonctionne déjà, mais de comprendre dans quelles conditions un foundation model pour données tabulaires peut offrir un avantage par rapport à des modèles prédictifs déjà établis.
Pour l’instant, nous ne déplaçons donc rien en production.
Mais nous continuerons à tester TabFM et à suivre son évolution.
Car la question la plus utile n’est probablement pas simplement « foundation model ou modèles prédictifs ? »
Il s’agit plutôt de comprendre quelle approche utiliser, avec quelles données et pour quel type de décision.