TabFM è un modello sviluppato da Google Research per attività di classificazione e regressione che introduce un approccio diverso rispetto ai tradizionali workflow di machine learning sui dati strutturati.
Non richiede di addestrare un nuovo modello sui propri dati. Utilizza invece l’in-context learning: lo storico viene passato come contesto e TabFM utilizza gli esempi ricevuti per generare le previsioni direttamente in fase di inferenza.
È un approccio simile, concettualmente, a quello dei modelli linguistici quando ricevono esempi all’interno del prompt.
Google ha inoltre integrato TabFM direttamente in BigQuery, dove può essere utilizzato tramite SQL con AI.PREDICT e valutato con AI.EVALUATE, senza dover gestire separatamente training e deployment del modello.
La domanda che ci siamo posti è stata quindi abbastanza naturale:
quanto può essere competitivo questo approccio rispetto ai modelli della ByTek Prediction Platform di tipo ML che utilizziamo già in produzione?
Per provare a capirlo abbiamo fatto alcuni test.
Impostazione dell’analisi
Abbiamo preso tre dataset reali con caratteristiche piuttosto diverse e confrontato TabFM con i modelli BPP su task di classificazione.
Una premessa è importante: non è un benchmark definitivo e non vuole stabilire quale tecnologia sia migliore in assoluto.
È un’analisi esplorativa, condotta su tre casi specifici, che ci è sembrata interessante da condividere.
I dataset utilizzati:
Dataset A
Feature prevalentemente anagrafiche e di canale.
Positivi: 6,5%
Dataset B
Feature comportamentali più ricche, come trial, demo e accessi.
Positivi: 11,8%
Dataset C
Dati anagrafici e transazionali.
Positivi: 27,9%
Per confrontare i risultati abbiamo osservato soprattutto due metriche: ROC-AUC e PR-AUC.
La ROC-AUC misura quanto bene il modello riesce a ordinare complessivamente la popolazione, separando i casi più probabilmente positivi da quelli negativi.
La PR-AUC concentra invece maggiormente l’attenzione sulla capacità di individuare correttamente i positivi. Diventa particolarmente interessante quando la classe positiva è minoritaria e quando, operativamente, conta soprattutto identificare bene la parte alta della classifica.
Risultati del confronto
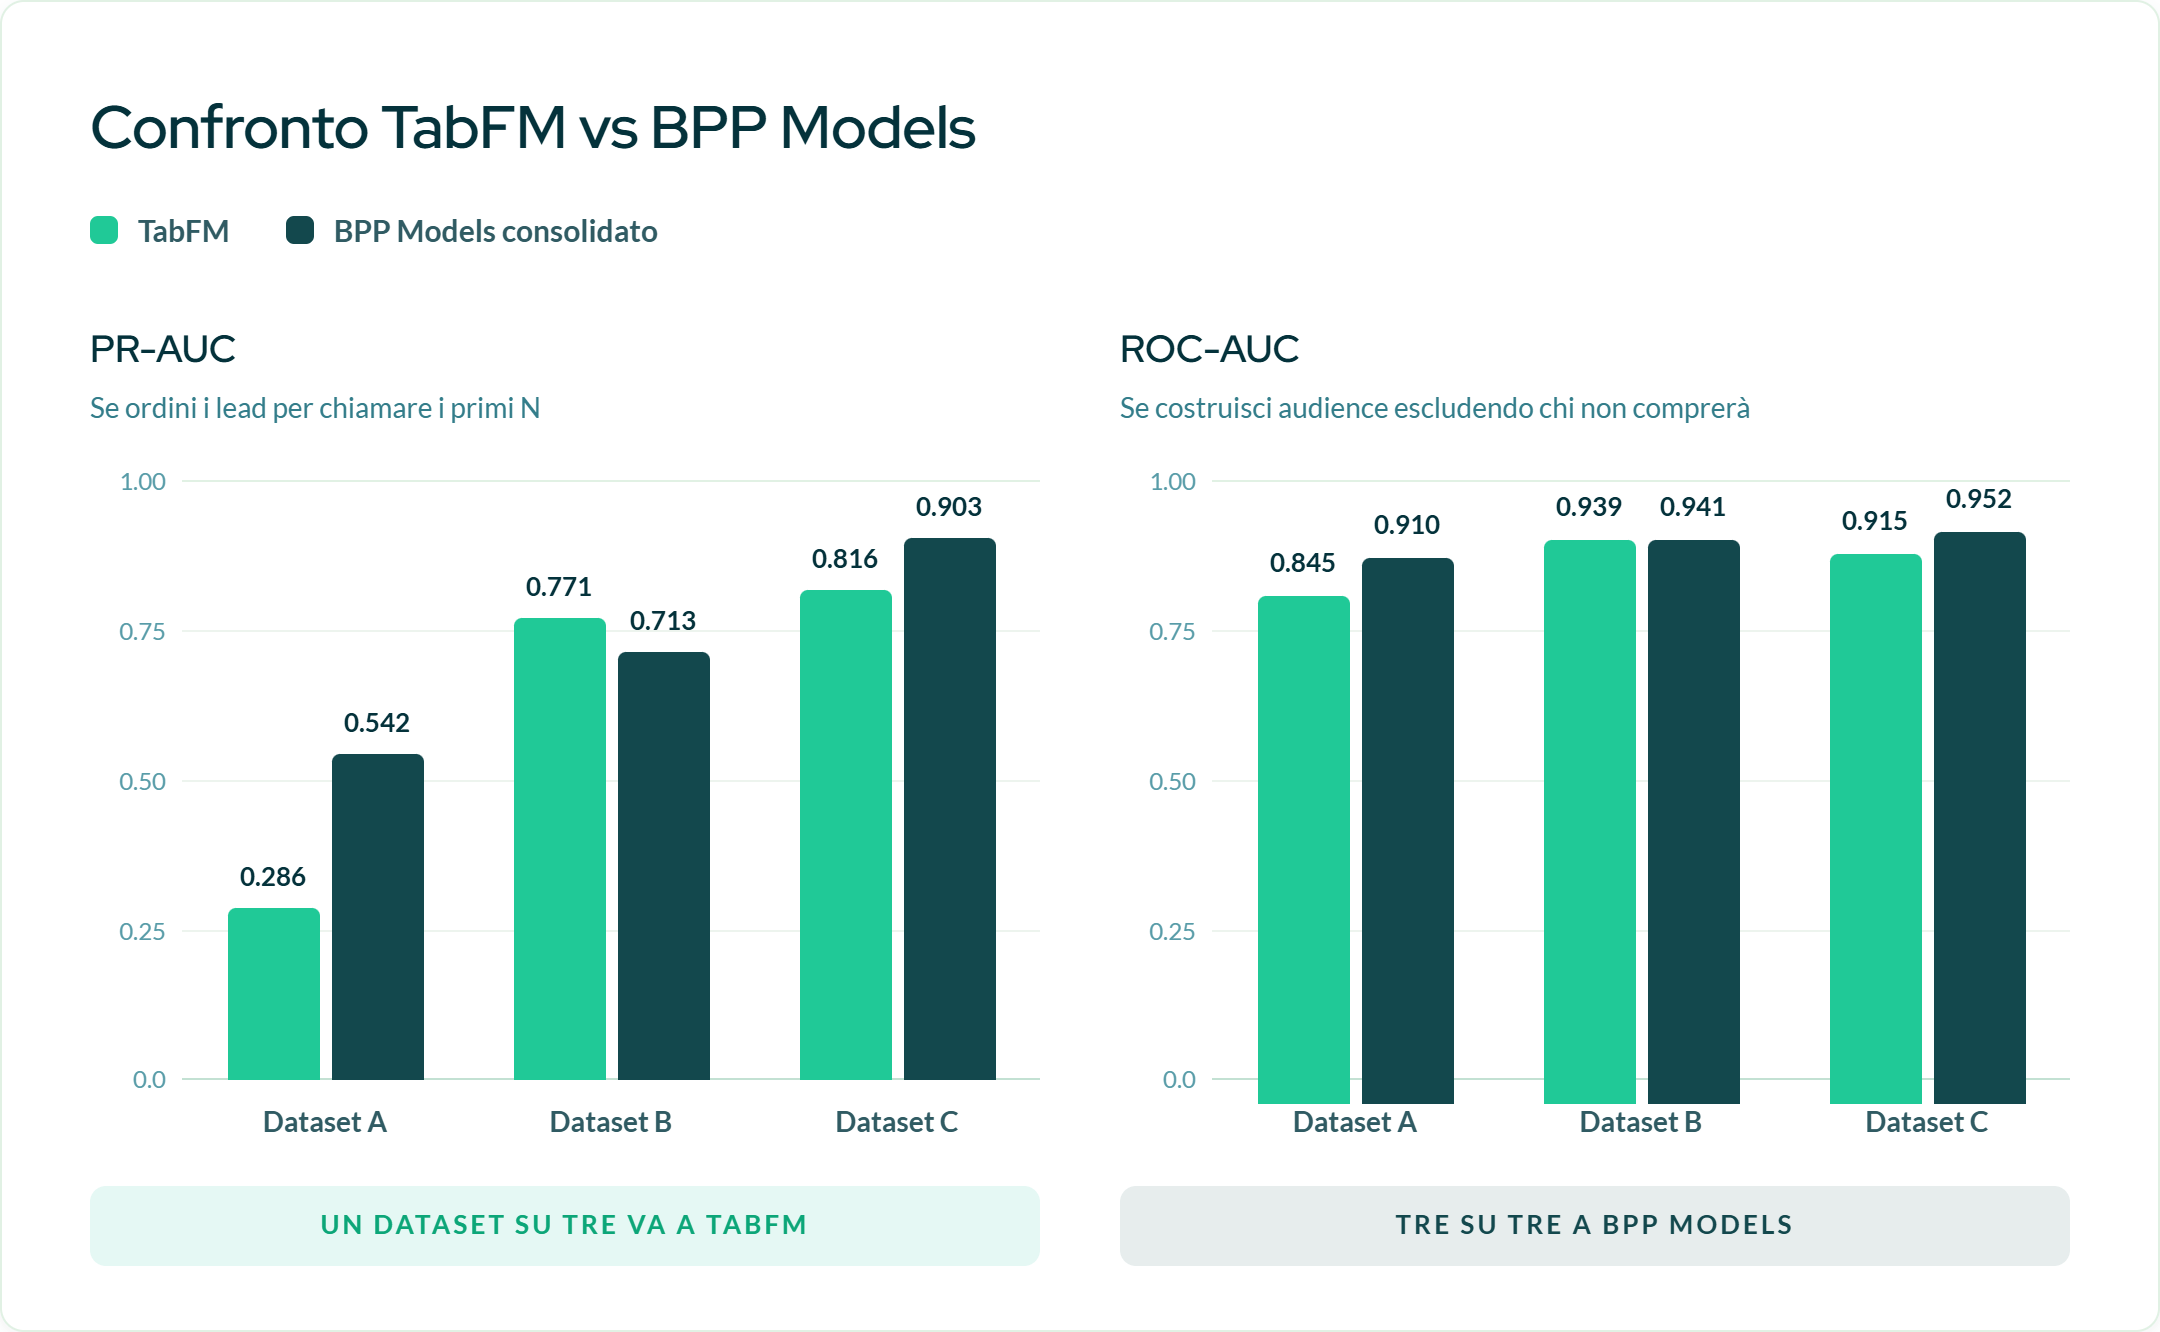
Sulla ROC-AUC, i modelli BPP ottengono il risultato migliore su tutti e tre i dataset.
Sul Dataset B, però, la distanza è di appena 0,002 punti: di fatto, un risultato molto vicino.
Sulla PR-AUC il quadro è più articolato.
I modelli BPP ottengono il risultato migliore su due dataset: in maniera molto netta sul Dataset A e con un vantaggio più contenuto sul Dataset C.
TabFM prevale invece sul Dataset B, quello caratterizzato dal maggior numero di segnali comportamentali.
I risultati, TabFM vs modelli BPP:
| Dataset | PR-AUC TabFM | PR-AUC BPP | ROC-AUC TabFM | ROC-AUC BPP |
| A | 0,286 | 0,542 | 0,845 | 0,910 |
| B | 0,771 | 0,713 | 0,939 | 0,941 |
| C | 0,816 | 0,903 | 0,915 | 0,952 |
Naturalmente, la metrica più rilevante dipende dal modo in cui la previsione viene utilizzata.
Se il modello serve, ad esempio, a ordinare i lead per decidere quali contattare per primi, la qualità della parte alta della classifica diventa fondamentale e la PR-AUC può essere particolarmente significativa.
Se invece il prediction score viene utilizzato per costruire audience, segmentare una popolazione o escludere utenti con una probabilità molto bassa di conversione, diventa altrettanto importante la qualità dell’ordinamento complessivo, quindi la ROC-AUC.
Effetto dell’aumento delle risorse computazionali
Sul Dataset A abbiamo voluto verificare se aumentando considerevolmente il contesto e il carico computazionale il divario potesse ridursi.
Siamo passati:
- da 1.000 a 10.000 righe di contesto;
- da 4 a 16 estimatori.
In termini di workload, circa 40 volte di più.
La PR-AUC è passata da 0,249 a 0,286.
Il primo incremento ha prodotto un miglioramento relativo di circa l’11%. Successivamente, ogni ulteriore triplicazione delle risorse ha portato un incremento nell’ordine dell’1,8%.
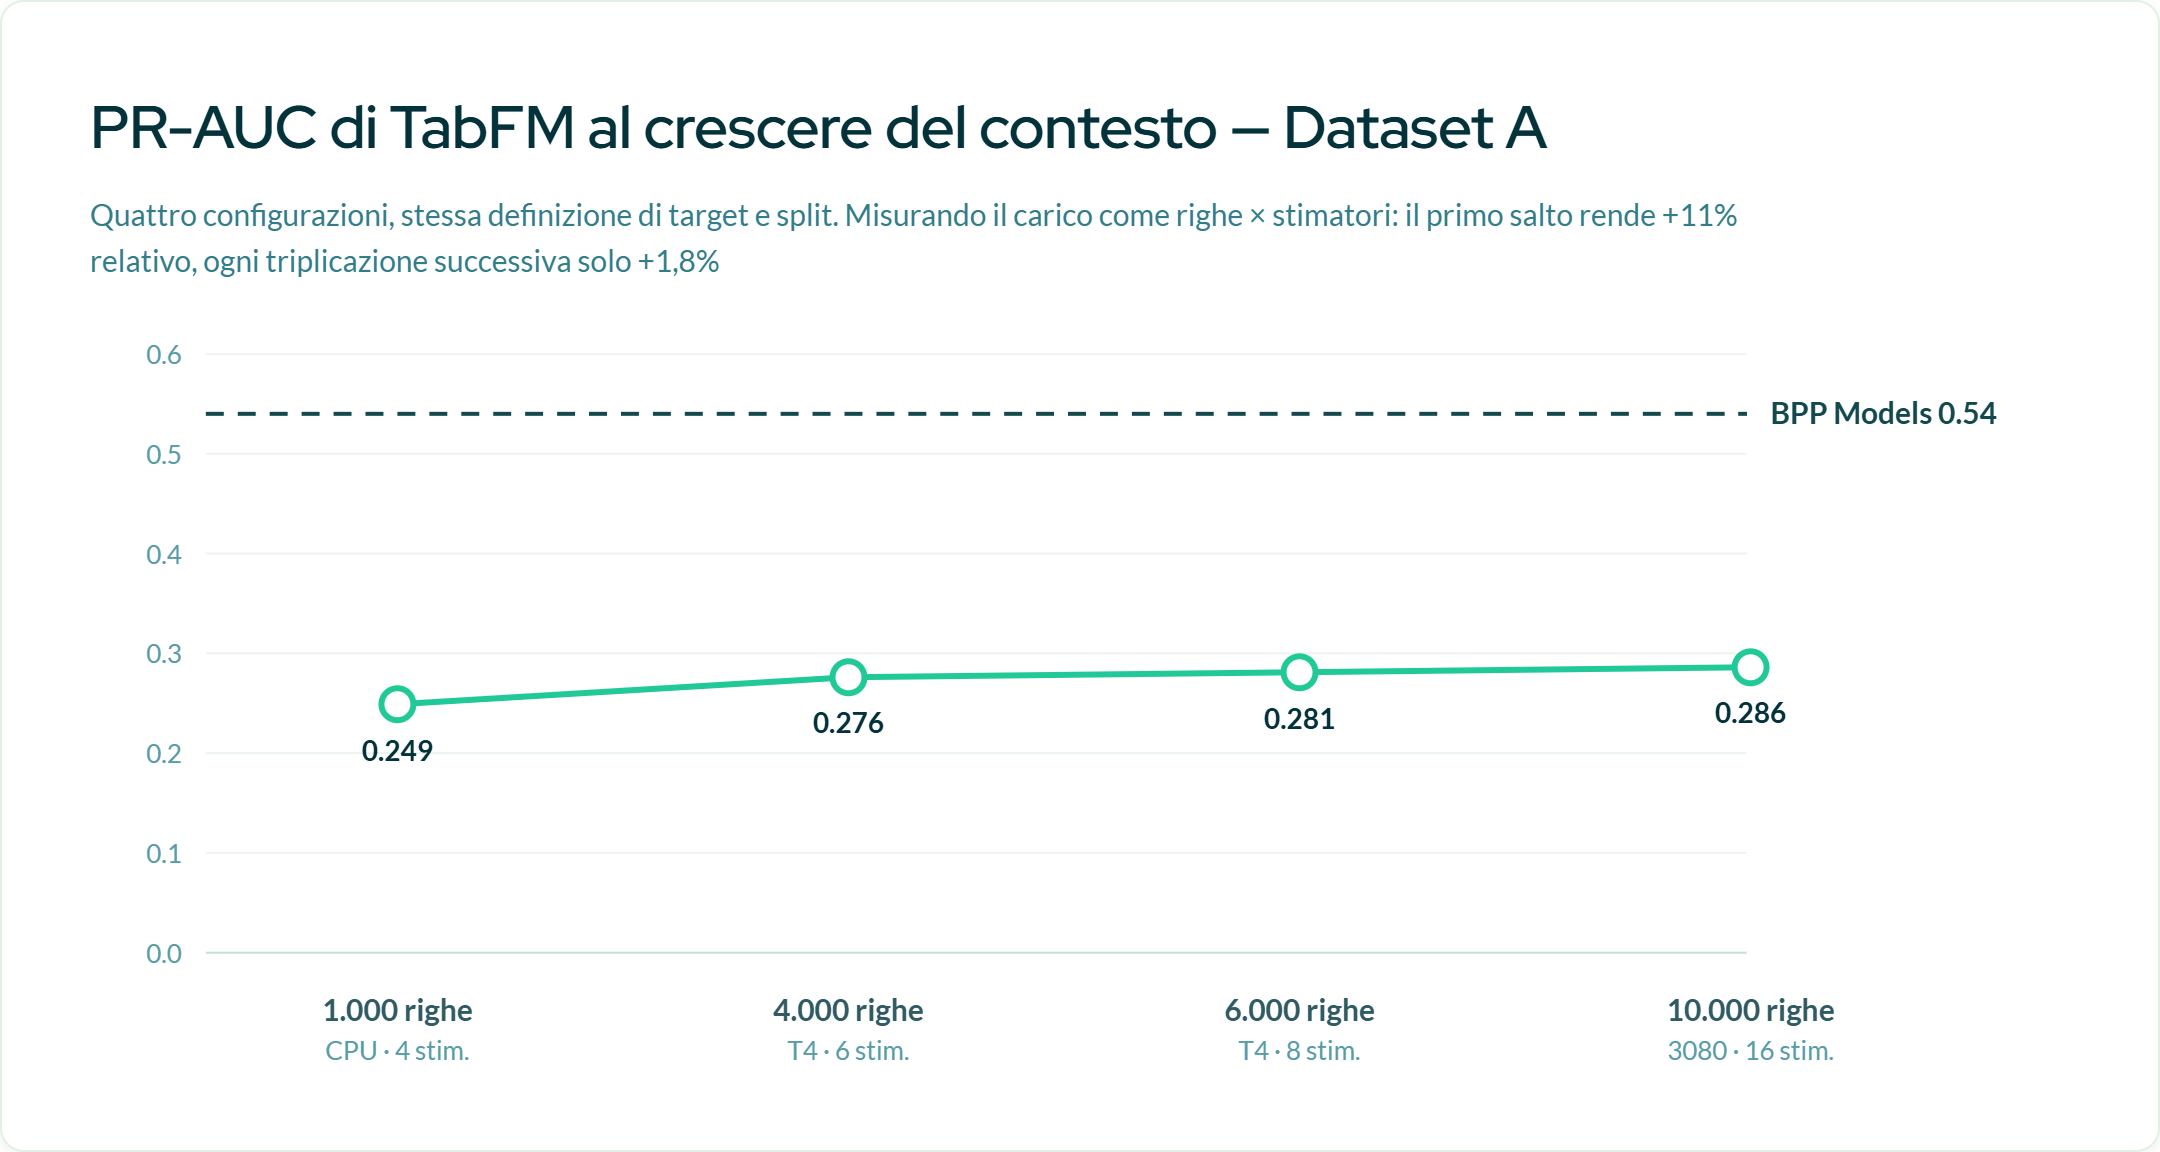
In questo caso, quindi, l’aumento della capacità computazionale non è stato sufficiente a chiudere il divario con il modello BPP.
Ed è proprio qui che entra in gioco un altro elemento della valutazione: le prestazioni predictive sono solo una parte del problema.
Limiti architetturali e operativi
Durante i nostri test con la libreria e i pesi pretrained di TabFM sono emersi alcuni limiti che vale la pena considerare.
- Memoria disponibile
Nei test locali siamo arrivati all’out-of-memory prima di raggiungere alcuni dei parametri teoricamente utilizzabili dalla libreria, sia su una Tesla T4 da 15 GB sia su una RTX 3080 da 20 GB, lavorando con un dataset da circa 45.000 righe di training.
Il motivo è legato alla natura stessa dell’in-context learning: più storico viene fornito al modello come contesto, maggiori sono le risorse necessarie in inferenza.
L’integrazione gestita in BigQuery affronta questo problema diversamente, attraverso sampling e inferenza distribuita, ma il principio rimane: la quantità di contesto incide sul costo computazionale.
- Costi di inferenza
Con un modello tradizionalmente addestrato il costo maggiore si concentra nella fase di training e retraining; una volta prodotto il modello, ogni nuova previsione non richiede di reinterpretare nuovamente l’intero training set.
Con un modello basato sull’in-context learning, invece, il contesto fa parte del processo di inferenza.
Questo cambia anche il modo in cui bisogna ragionare sui costi, soprattutto quando lo scoring deve essere ripetuto frequentemente o su grandi quantità di utenti.
Nell’integrazione BigQuery, infatti, l’utilizzo di TabFM è associato a un modello di pricing legato alla quantità di token elaborati.
- Limiti del modello
Nell’attuale integrazione BigQuery sono previste al massimo 10 classi per i problemi di classificazione e fino a 20 feature.
La libreria non mette inoltre a disposizione nativamente strumenti di feature importance paragonabili a quelli che normalmente utilizziamo nei nostri workflow: eventuali analisi di interpretabilità richiedono quindi lavorazioni aggiuntive.
- Maturità e condizioni di utilizzo
TabFM è ancora un progetto relativamente giovane.
Il codice è open source, ma i pesi pretrained della versione attuale hanno una licenza separata che ne limita l’utilizzo commerciale e in produzione. Il repository specifica inoltre che la libreria non è un prodotto Google ufficialmente supportato.
L’integrazione BigQuery è invece attualmente disponibile in Preview.
Sono aspetti che incidono poco in fase di sperimentazione, ma diventano più rilevanti quando si valuta l’adozione all’interno di pipeline predittive in produzione.
Considerazioni finali
Alla luce dei test, oggi non vediamo motivi per sostituire i modelli BPP.
Nei nostri esperimenti, hanno ottenuto i risultati migliori su due dataset su tre nella PR-AUC e su tutti e tre nella ROC-AUC.
Allo stesso tempo, il risultato del Dataset B ci sembra particolarmente interessante: con segnali comportamentali ricchi, TabFM è riuscito non solo ad avvicinarsi molto ai nostri modelli sulla ROC-AUC, ma anche a superarli sulla PR-AUC.
C’è poi un secondo scenario in cui questo tipo di approccio potrebbe diventare particolarmente rilevante: i dataset piccoli.
I modelli BPP devono apprendere la struttura del problema dai dati disponibili. Quando gli esempi diventano pochi, diventa inevitabilmente più difficile costruire un modello robusto.
Un foundation model parte invece da conoscenze apprese durante il pre-training e utilizza i nuovi dati come contesto.
È probabilmente qui che si trova uno degli aspetti più interessanti da approfondire.
Non tanto sostituire ciò che funziona già, quanto capire in quali condizioni un tabular foundation model possa offrire un vantaggio rispetto a modelli predittivi consolidati.
Per ora, quindi, non stiamo spostando nulla in produzione.
Ma continueremo a testare TabFM e a seguirne l’evoluzione.
Perché la domanda più utile, alla fine, non è semplicemente “foundation model o modelli predittivi?”.
È capire quale approccio utilizzare, con quali dati e per quale tipo di decisione.