TabFM ist ein von Google Research entwickeltes Modell für Klassifikations- und Regressionsaufgaben. Es verfolgt einen anderen Ansatz als traditionelle Machine-Learning-Workflows für strukturierte Daten.
Anstatt ein neues Modell mit den eigenen Daten zu trainieren, nutzt TabFM In-Context Learning: Historische Daten werden dem Modell als Kontext zur Verfügung gestellt, und TabFM verwendet diese Beispiele, um direkt während der Inferenz Vorhersagen zu generieren.
Konzeptionell ähnelt dieser Ansatz der Funktionsweise von Sprachmodellen, wenn ihnen Beispiele direkt innerhalb eines Prompts bereitgestellt werden.
Möchten Sie diese Strategie umsetzen?
Unsere KI-Modelle helfen Ihnen, diese Ergebnisse in Wochen statt Monaten zu erzielen.
Google hat TabFM außerdem direkt in BigQuery integriert. Dort kann es über SQL mit AI.PREDICT verwendet und mit AI.EVALUATE bewertet werden, ohne Training und Deployment des Modells separat verwalten zu müssen.
Das führte uns zu einer naheliegenden Frage:
Wie konkurrenzfähig ist dieser Ansatz im Vergleich zu den ML-basierten Modellen, die bereits in der ByTek Prediction Platform eingesetzt werden?
Also haben wir einige Tests durchgeführt.
Methodik der Analyse
Wir haben drei reale Datensätze mit unterschiedlichen Eigenschaften ausgewählt und TabFM bei Klassifikationsaufgaben mit den BPP-Modellen verglichen.
Eine wichtige Vorbemerkung: Dies ist kein abschließender Benchmark und soll nicht bestimmen, welche Technologie grundsätzlich besser ist.
Es handelt sich um eine explorative Analyse auf Basis von drei konkreten Anwendungsfällen, deren Ergebnisse wir interessant genug fanden, um sie zu teilen.
Die Datensätze:
Dataset A
Überwiegend demografische und kanalbezogene Features.
Anteil positiver Fälle: 6,5 %
Dataset B
Umfangreichere Verhaltens-Features, darunter Trials, Demos und Logins.
Anteil positiver Fälle: 11,8 %
Dataset C
Demografische und transaktionale Daten.
Anteil positiver Fälle: 27,9 %
Für den Leistungsvergleich haben wir uns hauptsächlich auf zwei Metriken konzentriert: ROC-AUC und PR-AUC.
Die ROC-AUC misst, wie gut das Modell die gesamte Population einordnet und dabei Fälle mit einer höheren Wahrscheinlichkeit für ein positives Ergebnis von solchen mit einer höheren Wahrscheinlichkeit für ein negatives Ergebnis unterscheidet.
Die PR-AUC konzentriert sich stärker darauf, wie zuverlässig das Modell positive Fälle identifiziert. Sie ist besonders relevant, wenn die positive Klasse in der Minderheit ist und operativ vor allem die Qualität der obersten Positionen im Ranking zählt.
Ergebnisse des Vergleichs
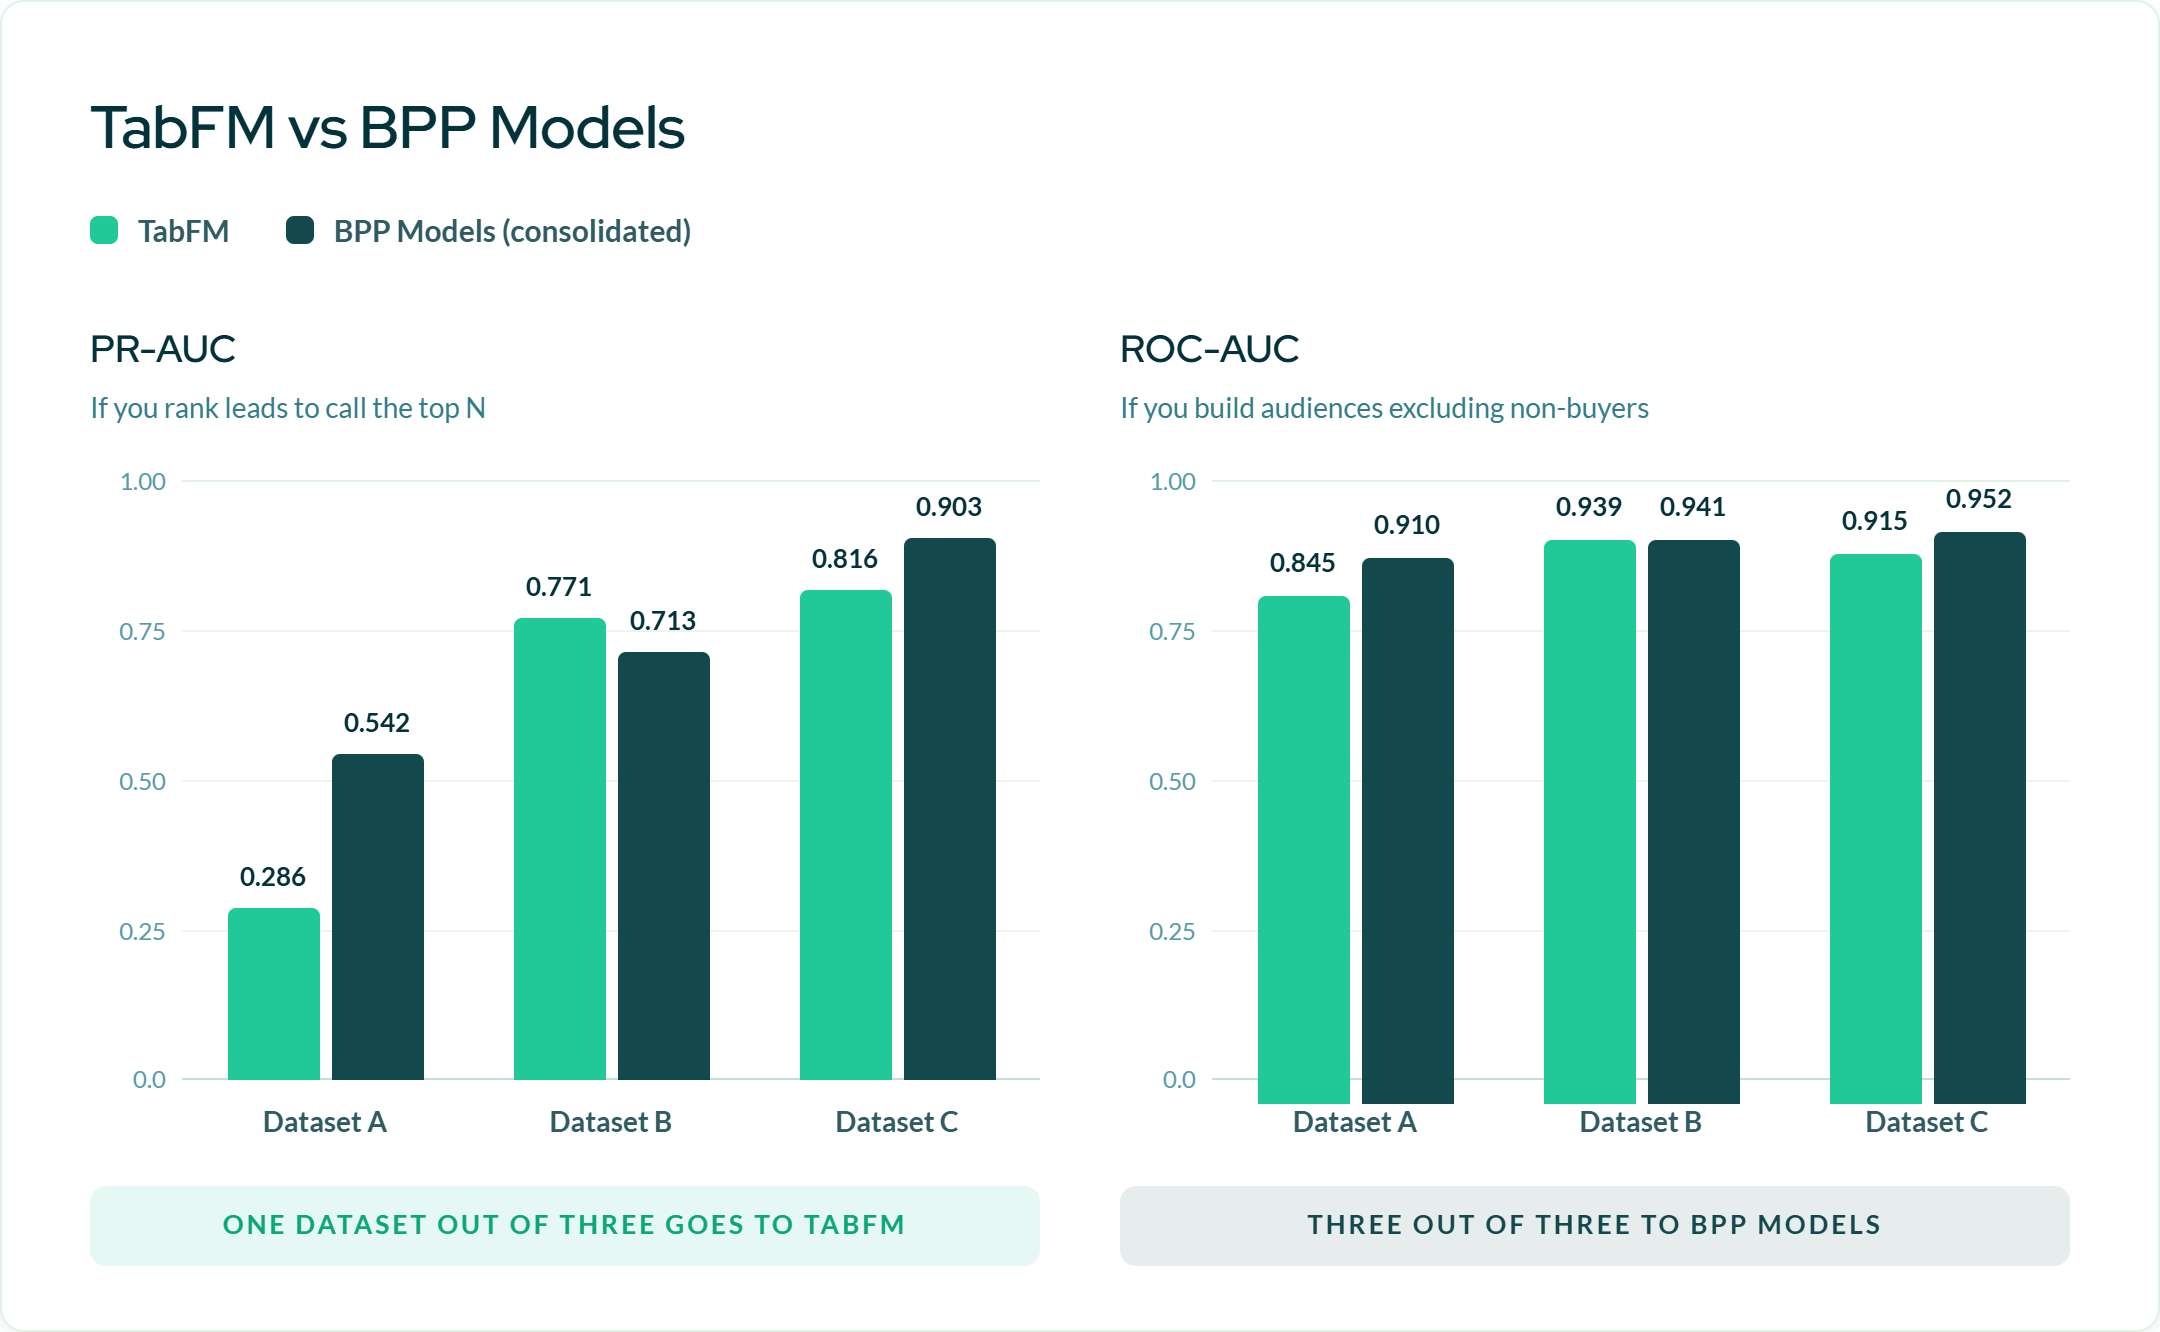
Bei der ROC-AUC erzielten die BPP-Modelle auf allen drei Datensätzen die besten Ergebnisse.
Beim Dataset B beträgt der Unterschied allerdings nur 0,002 Punkte – praktisch also ein sehr ähnliches Ergebnis.
Bei der PR-AUC ist das Bild differenzierter.
Die BPP-Modelle schneiden auf zwei Datensätzen besser ab: mit einem deutlichen Vorsprung bei Dataset A und einem geringeren Vorteil bei Dataset C.
TabFM erzielt dagegen bei Dataset B das bessere Ergebnis, also bei dem Datensatz mit den umfangreichsten Verhaltenssignalen.
Die Ergebnisse, TabFM vs. BPP-Modelle:
| Dataset | PR-AUC TabFM | PR-AUC BPP | ROC-AUC TabFM | ROC-AUC BPP |
|---|---|---|---|---|
| A | 0,286 | 0,542 | 0,845 | 0,910 |
| B | 0,771 | 0,713 | 0,939 | 0,941 |
| C | 0,816 | 0,903 | 0,915 | 0,952 |
Welche Metrik am relevantesten ist, hängt natürlich davon ab, wie die Vorhersage eingesetzt werden soll.
Wenn das Modell beispielsweise dazu dient, Leads zu priorisieren und zu entscheiden, welche zuerst kontaktiert werden sollen, ist die Qualität an der Spitze des Rankings entscheidend. In diesem Fall kann die PR-AUC besonders aussagekräftig sein.
Wird der Prediction Score dagegen genutzt, um Audiences zu erstellen, eine Population zu segmentieren oder Nutzer mit einer sehr niedrigen Conversion-Wahrscheinlichkeit auszuschließen, spielt auch die Qualität des gesamten Rankings eine wichtige Rolle – und damit die ROC-AUC.
Auswirkungen zusätzlicher Rechenressourcen
Bei Dataset A wollten wir überprüfen, ob sich der Abstand durch eine deutliche Erhöhung der Kontextgröße und des Rechenaufwands verringern lässt.
Wir erhöhten:
- die Kontextgröße von 1.000 auf 10.000 Zeilen;
- die Anzahl der Estimators von 4 auf 16.
Insgesamt entsprach das einer etwa 40-fachen Erhöhung des Workloads.
Die PR-AUC stieg von 0,249 auf 0,286.
Die erste Erhöhung führte zu einer relativen Verbesserung von rund 11 %. Danach brachte jede weitere Verdreifachung der Ressourcen einen Zuwachs von etwa 1,8 %.
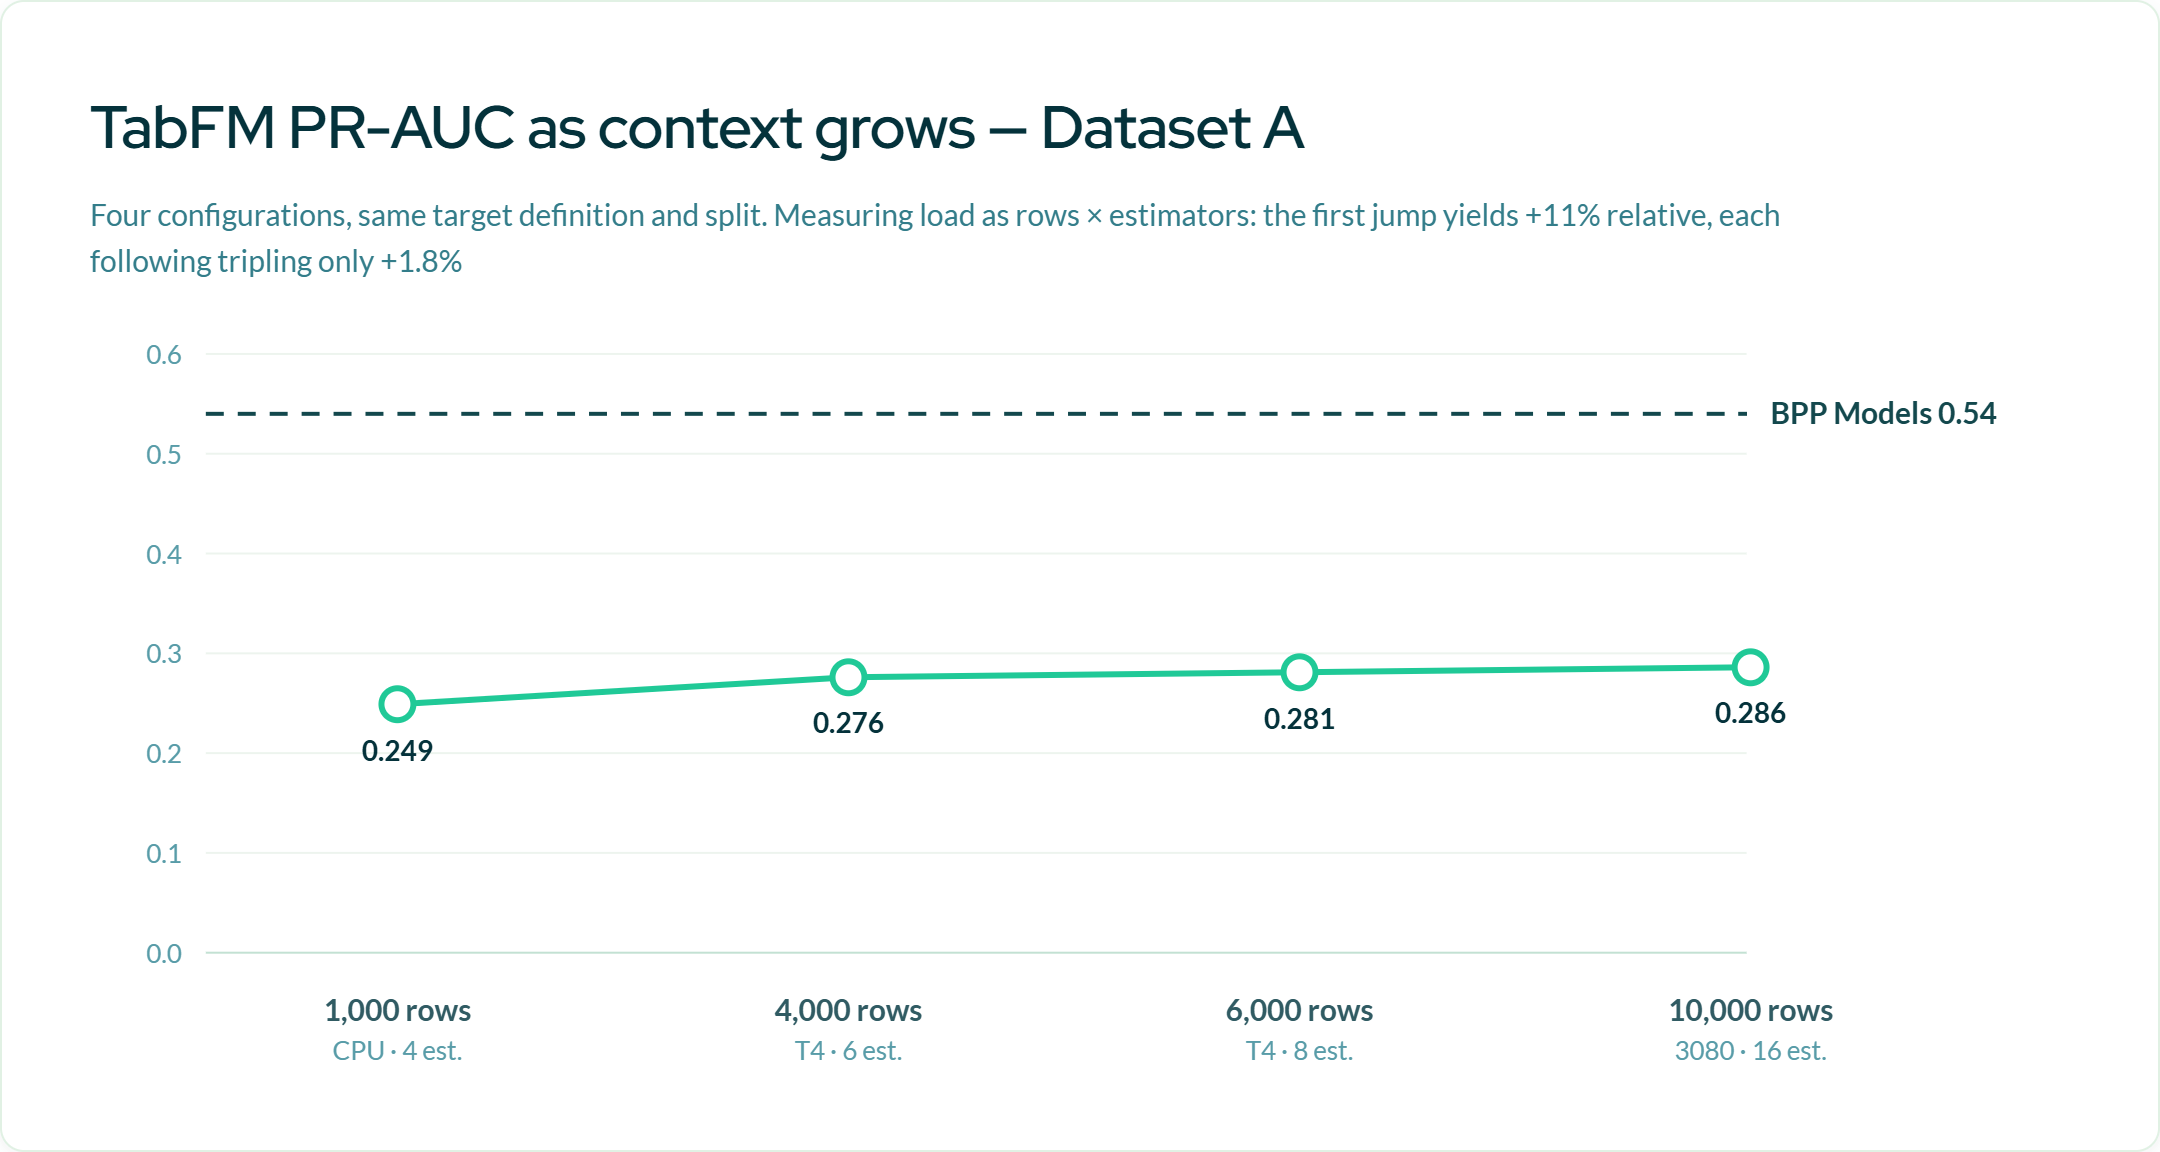
In diesem Fall war die Erhöhung der Rechenressourcen also nicht ausreichend, um den Abstand zum BPP-Modell zu schließen.
Und genau hier kommt ein weiterer wichtiger Aspekt der Bewertung ins Spiel: Die Vorhersagequalität ist nur ein Teil der Gleichung.
Architektonische und operative Einschränkungen
Bei unseren Tests mit der TabFM-Bibliothek und den vortrainierten Gewichten sind einige Einschränkungen aufgefallen, die bei einer Bewertung berücksichtigt werden sollten.
1. Verfügbarer Speicher
In unseren lokalen Tests traten Out-of-Memory-Fehler auf, noch bevor wir einige der theoretisch verfügbaren Parameter der Bibliothek erreichten – sowohl auf einer Tesla T4 mit 15 GB Speicher als auch auf einer RTX 3080 mit 20 GB bei einem Trainingsdatensatz von rund 45.000 Zeilen.
Das hängt mit der grundlegenden Funktionsweise des In-Context Learnings zusammen: Je mehr historische Daten als Kontext bereitgestellt werden, desto mehr Ressourcen werden während der Inferenz benötigt.
Die verwaltete Integration in BigQuery geht mit diesem Problem anders um, unter anderem durch Sampling und verteilte Inferenz. Das Grundprinzip bleibt jedoch bestehen: Die Menge des Kontexts beeinflusst die Rechenkosten.
2. Inferenzkosten
Bei einem traditionell trainierten Modell entstehen die größten Kosten in der Regel während des Trainings und Retrainings. Sobald das Modell erstellt wurde, muss für jede neue Vorhersage nicht erneut der gesamte Trainingsdatensatz verarbeitet werden.
Bei einem auf In-Context Learning basierenden Modell ist der Kontext dagegen Bestandteil des eigentlichen Inferenzprozesses.
Dadurch verändert sich auch die Kostenbewertung – insbesondere dann, wenn Scoring regelmäßig wiederholt oder auf große Nutzerpopulationen angewendet werden muss.
Bei der BigQuery-Integration ist die Nutzung von TabFM dementsprechend mit einem Preismodell verbunden, das sich an der Menge der verarbeiteten Tokens orientiert.
3. Einschränkungen des Modells
In der aktuellen BigQuery-Integration werden bei Klassifikationsaufgaben bis zu 10 Klassen und bis zu 20 Features unterstützt.
Die Bibliothek bietet außerdem keine nativen Feature-Importance-Tools, die mit denen vergleichbar wären, die wir üblicherweise in unseren Workflows einsetzen. Zusätzliche Analysen zur Interpretierbarkeit erfordern daher separate Verarbeitungsschritte.
4. Reifegrad und Nutzungsbedingungen
TabFM ist noch ein relativ junges Projekt.
Der Code ist Open Source, während die aktuellen vortrainierten Gewichte einer separaten Lizenz unterliegen, die ihre kommerzielle Nutzung und den Einsatz in Produktion einschränkt. Im Repository wird zudem darauf hingewiesen, dass die Bibliothek kein offiziell unterstütztes Google-Produkt ist.
Die BigQuery-Integration ist derzeit als Preview verfügbar.
Während einer Experimentierphase spielen diese Aspekte eine vergleichsweise geringe Rolle. Bei der Bewertung eines Einsatzes in produktiven Predictive-Pipelines werden sie jedoch deutlich relevanter.
Fazit
Auf Grundlage unserer Tests sehen wir derzeit keinen Grund, die BPP-Modelle zu ersetzen.
In unseren Experimenten erzielten sie bei der PR-AUC auf zwei von drei Datensätzen die besten Ergebnisse und bei der ROC-AUC auf allen drei.
Gleichzeitig ist das Ergebnis von Dataset B besonders interessant: Bei umfangreichen Verhaltenssignalen kam TabFM bei der ROC-AUC nicht nur sehr nah an unsere Modelle heran, sondern übertraf sie sogar bei der PR-AUC.
Ein zweites Szenario, in dem dieser Ansatz besonders relevant werden könnte, sind kleine Datensätze.
BPP-Modelle müssen die Struktur eines Problems anhand der verfügbaren Daten erlernen. Wenn nur wenige Beispiele vorhanden sind, wird es zwangsläufig schwieriger, ein robustes Modell zu erstellen.
Ein Foundation Model dagegen greift bereits auf Wissen aus dem Pre-Training zurück und nutzt die neuen Daten als Kontext.
Genau darin liegt wahrscheinlich einer der interessantesten Aspekte, die es weiter zu untersuchen gilt.
Es geht nicht unbedingt darum, etwas zu ersetzen, das bereits funktioniert, sondern darum zu verstehen, unter welchen Bedingungen ein Foundation Model für tabellarische Daten einen Vorteil gegenüber etablierten Predictive Models bieten kann.
Vorerst werden wir daher nichts in Produktion verlagern.
Wir werden TabFM jedoch weiter testen und seine Entwicklung verfolgen.
Denn die eigentlich relevante Frage lautet wahrscheinlich nicht einfach „Foundation Model oder Predictive Models?“
Vielmehr geht es darum zu verstehen, welcher Ansatz mit welchen Daten und für welche Art von Entscheidung eingesetzt werden sollte.